File
MiniMax H3 First Last Frame LoRA Trainer Varianti: 4
0,01 $ / passaggio
10 crediti API / passaggio · ≈ 1,05 ₽
Nessuna corrispondenza. Prova “video”, “FLUX” o “webhooks”.
Caricamento dei modelli…
minimax/h3/ref2va/trainer
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.ru/v1/run/minimax/h3/ref2va/trainer?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "training_data_url": "https://example.com/your-file.zip"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.ru/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/minimax/h3/ref2va/trainer?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"training_data_url": "https://example.com/your-file.zip"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.ru/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"training_data_url": "https://example.com/your-file.zip",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/minimax/h3/ref2va/trainer", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"])# 1. Connect once (Claude Code; Cursor, VS Code, Claude Desktop: https://doitong.com/it/developers/docs/mcp)
claude mcp add --transport http doitong-models https://api.doitong.ru/v1/mcp \
--header "Authorization: Bearer $DOITONG_API_KEY"
# 2. Your agent calls the "run" tool with:
{
"model_id": "minimax/h3/ref2va/trainer",
"input": {
"training_data_url": "https://example.com/your-file.zip"
}
}Chiama il modello MiniMax H3 Reference to Video LoRA Trainer (minimax/h3/ref2va/trainer) tramite Doitong API. Documentazione per gli agenti: https://doitong.com/it/developers/models/minimax/h3/ref2va/trainer.md
POST https://api.doitong.ru/v1/run/minimax/h3/ref2va/trainer?wait=20
Authorization: Bearer $DOITONG_API_KEY
Content-Type: application/json
{
"training_data_url": "https://example.com/your-file.zip"
}
Se lo stato della risposta è "queued" o "running", interroga GET https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20 finché non diventa "succeeded"; i file si trovano in outputs[].url. POST https://api.doitong.ru/v1/quote/minimax/h3/ref2va/trainer con lo stesso body restituisce il prezzo esatto prima dell'esecuzione.Questa richiesta: 30,00 $ 30.000 crediti API · ≈ 3140,99 ₽ Esegui in questa pagina
La tua nuova chiave API. Viene mostrata solo ora ed è già presente nel codice e nel campo della chiave API qui sotto. Mantienila segreta: non inserirla mai nel codice eseguito in un browser.
Lavori pubblici creati con MiniMax H3 dalla community di Doitong. Riutilizza un prompt con un clic.
 Video
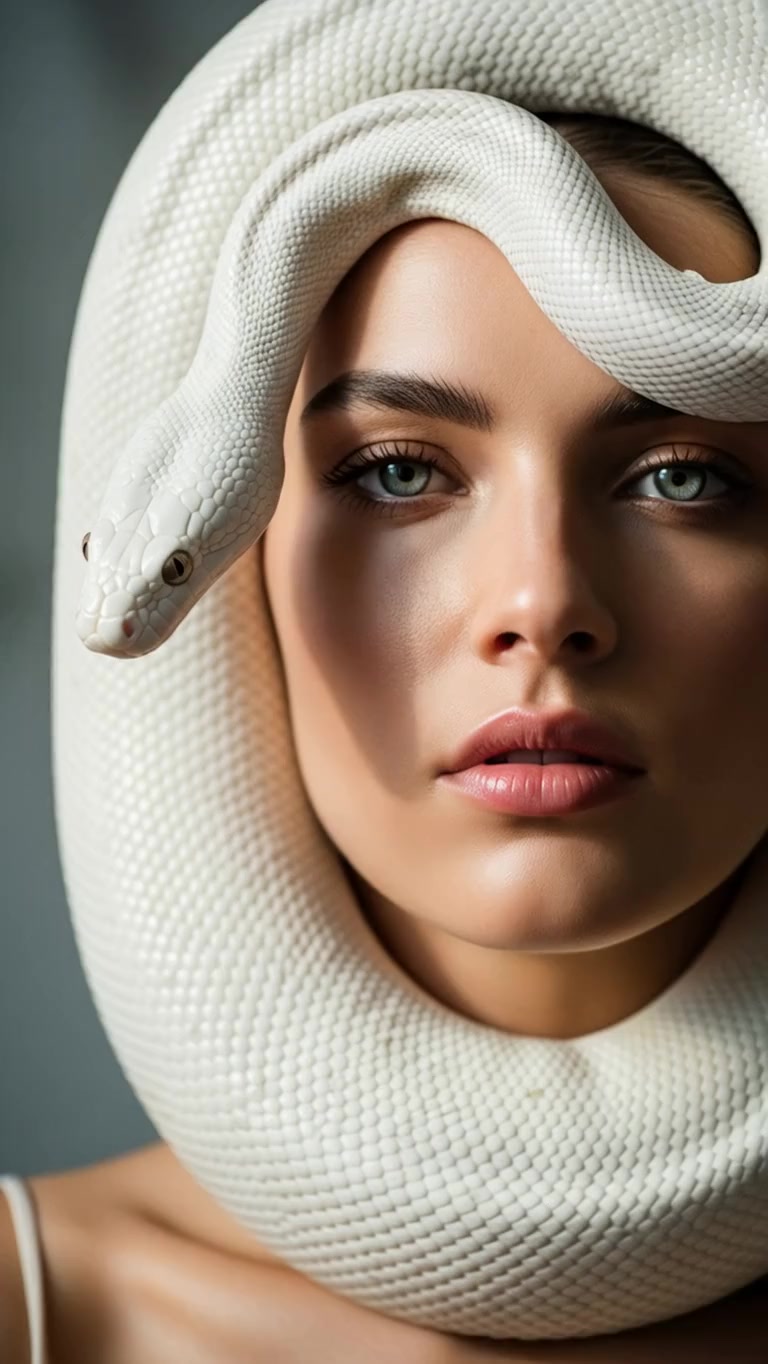
Close-up shot of a striking model with piercing eyes and flawless skin, a white snake elegantly coiled around her head and neck, its scales glistening in soft, diffused light. The camera gently zooms in, emphasizing the intricate texture of the snake’s scales and the model’s striking facial...
 Video
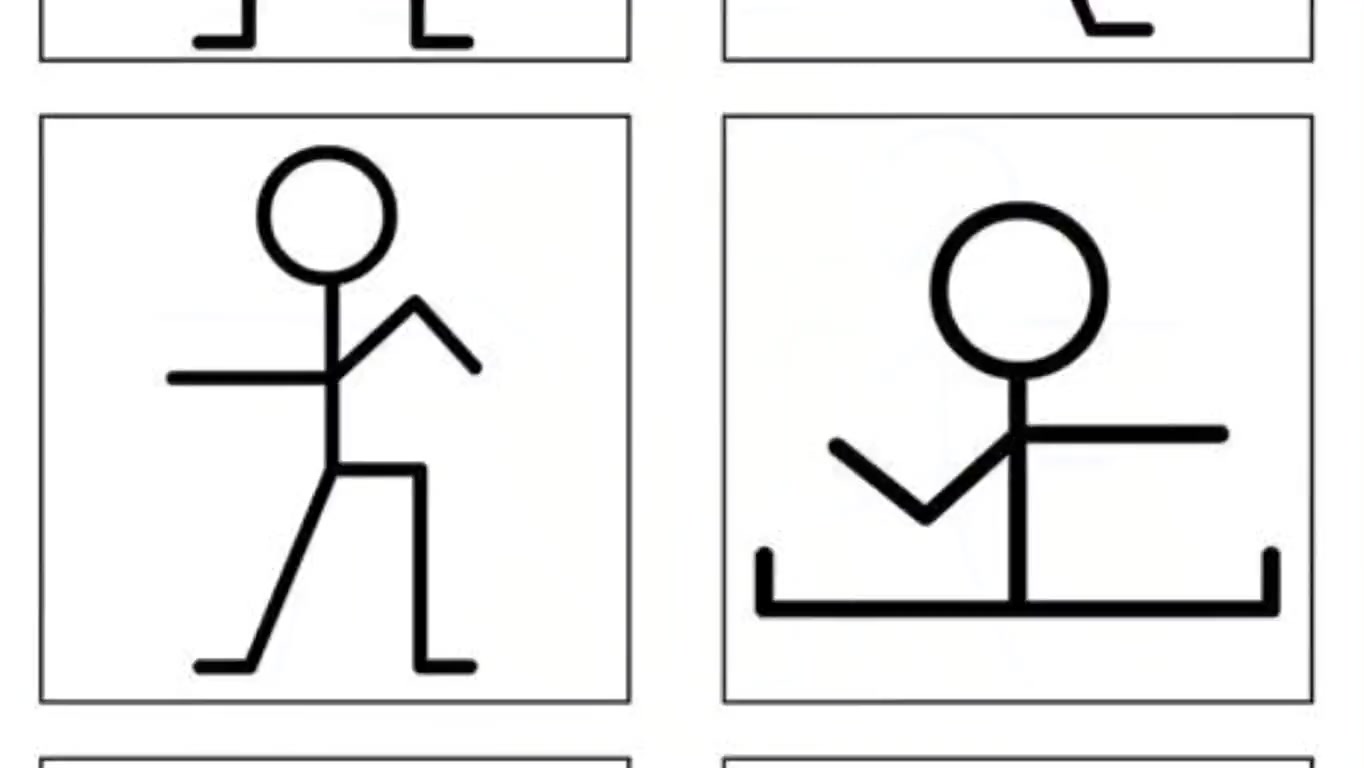
Animate the stickman drawings into a smooth dance animation. The simple black stick figure performs fun rhythmic dance moves — waving its arms, bending knees, jumping lightly, spinning, and swaying side to side in time with upbeat music. Keep the white background clean and minimal. The motion...
 Video
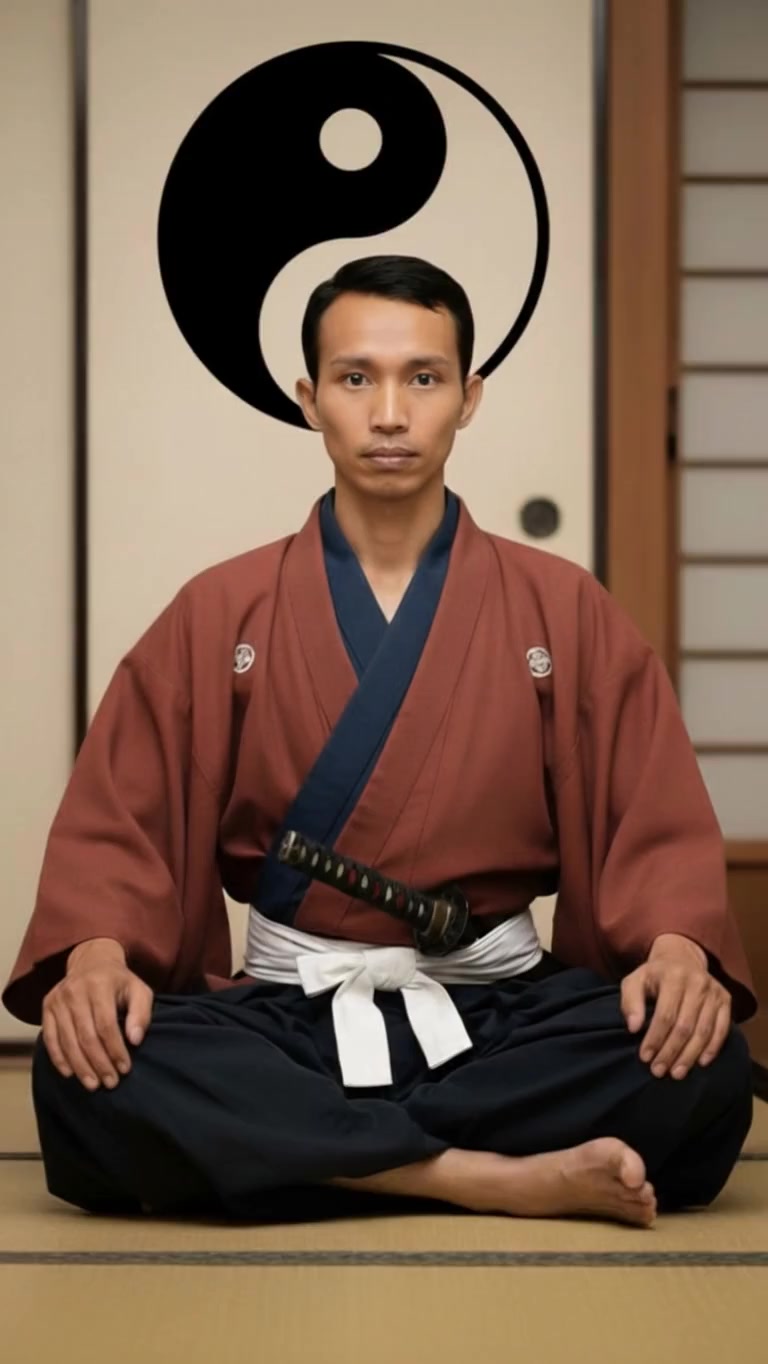
A hyper-realistic, cinematic transformation sequence of the man in the uploaded image, sitting in meditation inside a traditional Japanese room. The atmosphere begins to tremble slightly as soft blue light flows around him. From the ground, thousands of magnetic nano-particles rise, shimmering...
 Video
A cinematic transformation video of the man. The scene begins with him standing naturally, then looking down at his hands as glowing holographic projections appear around his body. Mechanical parts of the Iron Man armor start assembling piece by piece with smooth animation: chest plate forming,...
 Video
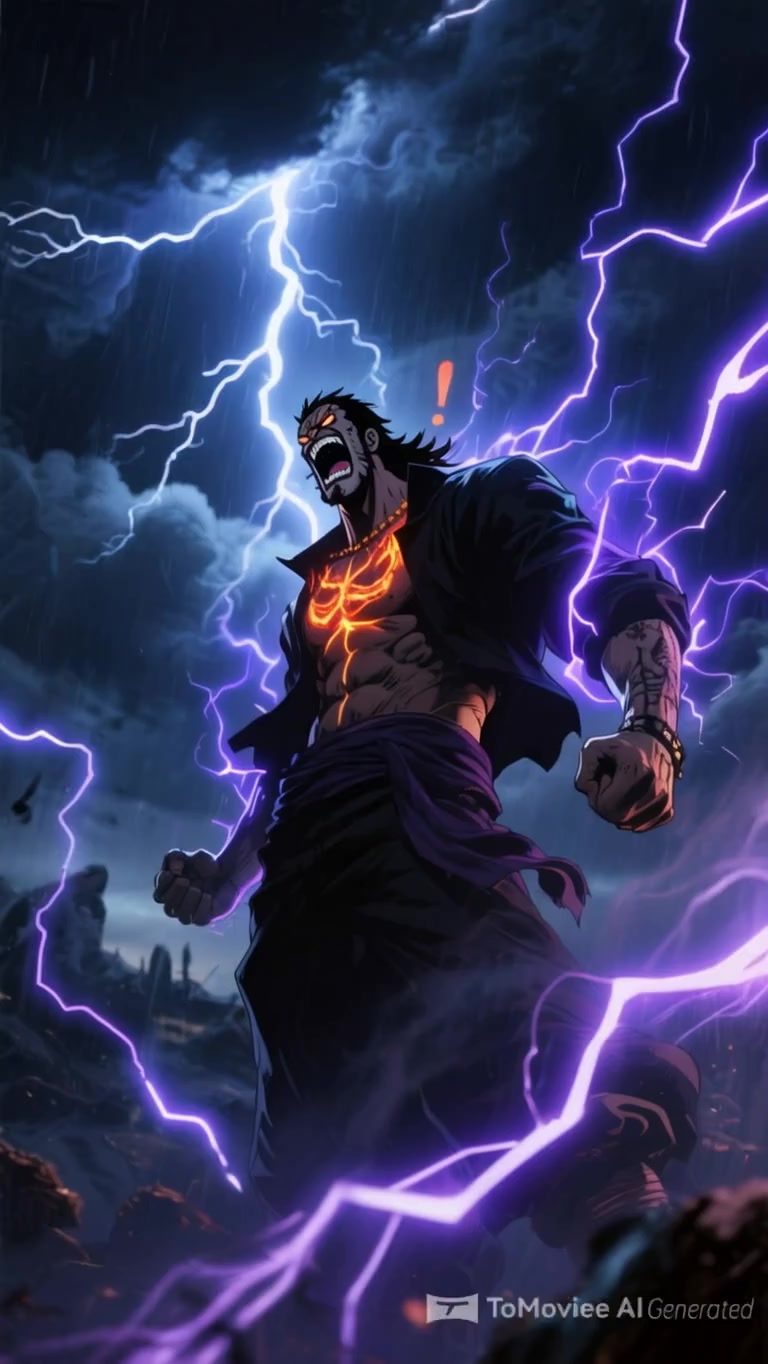
An ultra-epic anime cinematic of Luffy’s greatest enemy unleashing a terrifying blind rage, rampaging uncontrollably against nature itself. His gigantic body is surrounded by a storm of black and crimson energy, crackling with lightning that scorches the ground. His roar shakes the heavens,...
 Video
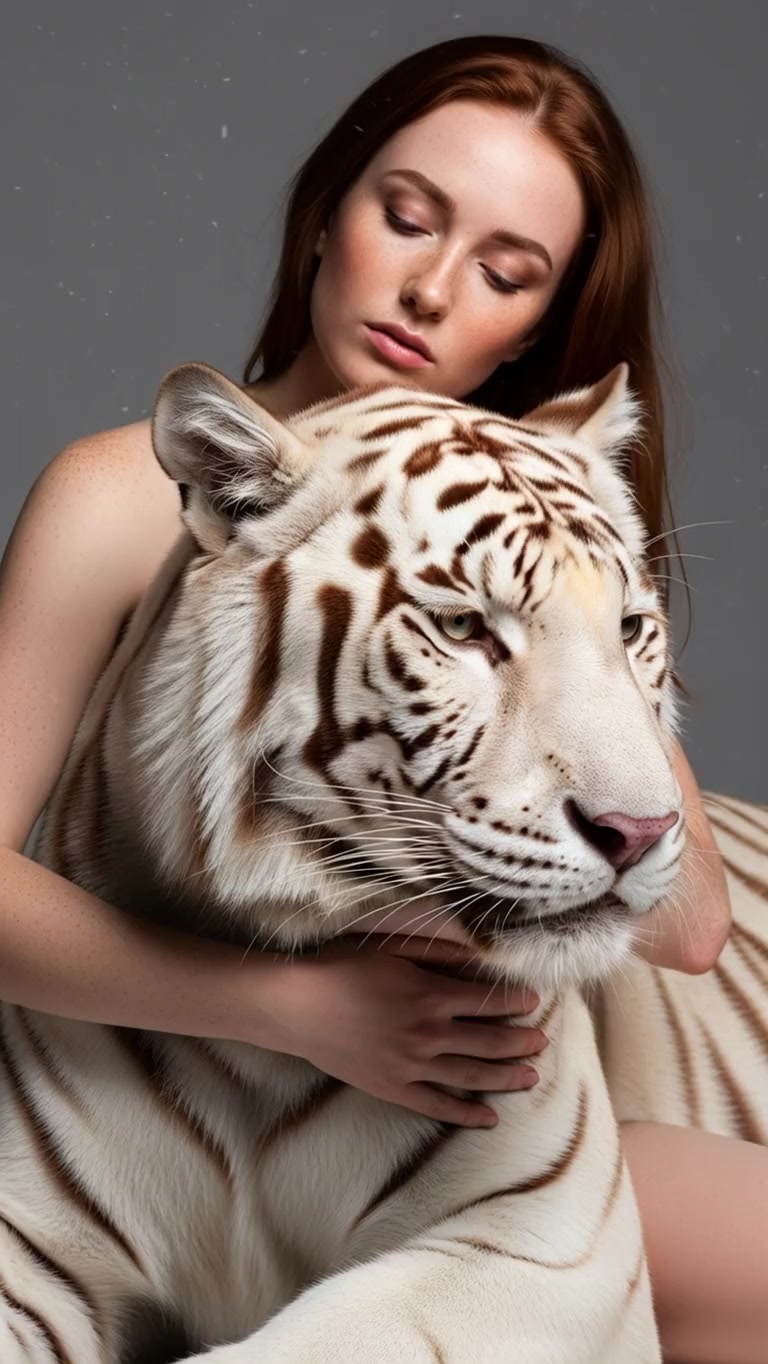
A fair-skinned red-haired woman with freckles tightly embraces a majestic white tiger with faint reddish stripes. They remain close, perfectly synchronized in stillness. The woman blinks slowly, slightly tilting her head with a serious and intense expression. The tiger breathes gently — its...
 Video
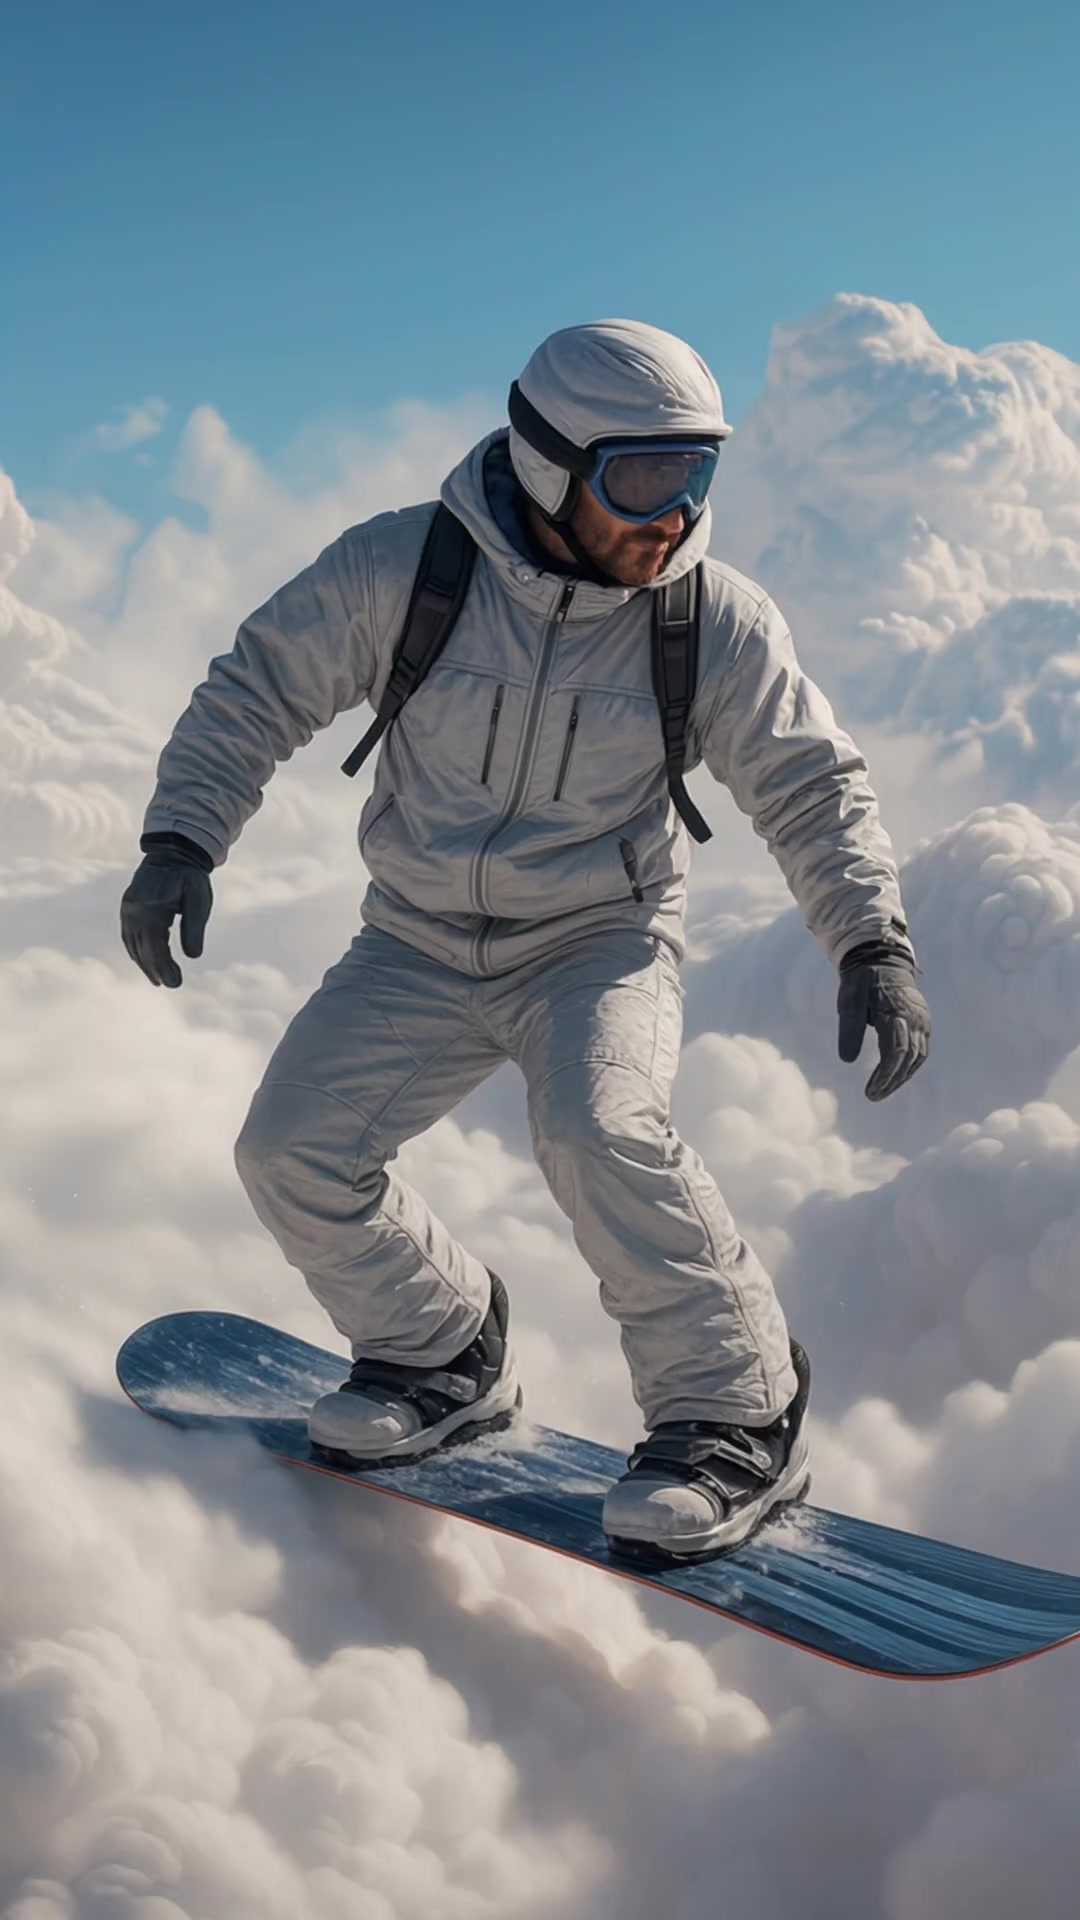
The snowboarder is riding across massive, fluffy white clouds as if they were snow-covered mountains, with dramatic lighting and deep shadows adding volume and realism. The background shows a stunning blue sky with scattered soft clouds and subtle light rays. crisp cinematic quality, vivid...
Используй это изображение как точный референс. Вертикальное реалистичное видео 9:16, тёплая кинематографичная ночная сцена в спальне. Полностью сохранить лица Ани и Павла, их внешность, причёски, одежду, освещение, кровать, панорамные окна и ночной город. Камера статичная, средний крупный план....
 Video
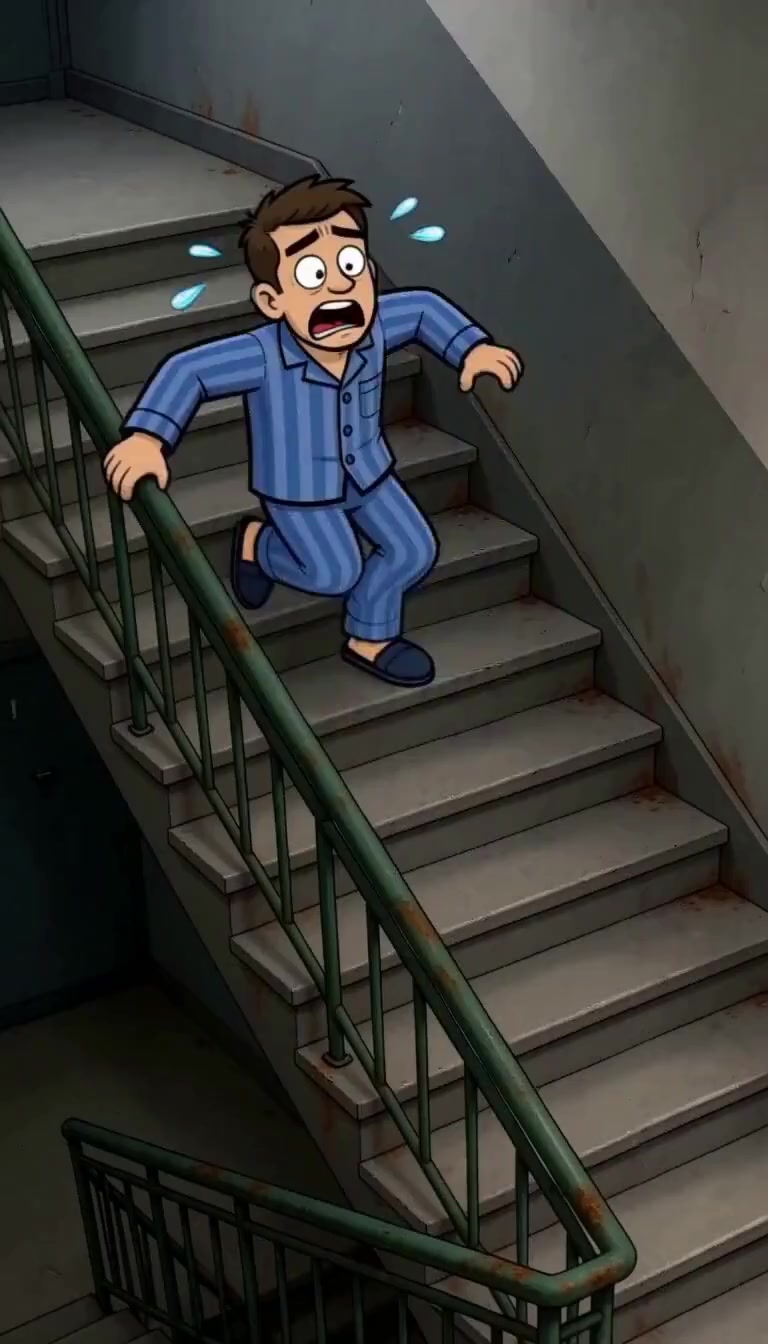
Героя Валеру не меняем . Валера в ужасе бежит вниз по лестнице в подъезде сильно хромает на правую ногу и держится за перила . Останавливается на лестничной площадки и потирает рукой правое колено на лице мучительная боль . Бежит дальше по лестнице открывает дверь подъездную , спотыкается и...
 Video
Первый кадр - взгляд от первого лица , моргание глаз и видно сначала мутно потом ясно. На белом фоне стоит спиной к нам в белом медицинском халате и шапочке тело с ярко аппетитными формами женского тела , ноги ниже халата ноги скелета в ярких ярких красных туфлях , двигает комично попой влево и...
 Video
На белом фоне . 9:16 Перед глазами Валеры закрывается шторка голубого цвета . Камера отдаляется и показывает Валеру без штанов и без тапок в операционной: на операционном столе Валера и половину тела разделяет медицинская шторка голубого цвета , а около ног стоит скелет в Маске и медицинском...
 Video
В расслабленном состоянии и довольные собой :Скелет ,сустав и доктор Ларин ( Доктор Ларин непрерывно двигает губами, как будто говорит, выразительные движения губ, оживление речи.) сидят за столом в комнате для отдыха и пьют чай Камера направляется на скелета , который делает глоток чая и...
 Video
Локацию не меняем , плакаты и расположение вещей не меняем .Меняем время зелёного цвета на часах на”03: 19” .Сверху на часах лежит медицинская шапочка скелета. Валере приснился страшный сон. он ворочается и в ужасе просыпается , сердце бьется сильно ,течет пот, он часто дышит , понимает ,что это...
Camera: dolly in. Медленная кинематографичная панорама Гели и её питомцев-хранителей на залитой солнцем деревянной террасе. Легкий ветерок шелестит листвой в саду, в воздухе парят золотистые пылинки. пусть она будет в шортиках и футболке в розовых сандалях. А Рокси голосом мужским приятным ....
Camera: static. Оживи это изображение строго в 2D-анимационном стиле. Сохрани формат 9:16. Не меняй стиль картинки, цветовую гамму и уровень детализации. В кадре уже есть Василиса. Её не генерировать заново. Остальные персонажи — за кадром. Их не показывать, не добавлять, не рисовать. Порядок...
Slapstick Tom & Jerry style silent comedy, Pixar-quality 3D animation, 16:9, Malar Sunai — a glowing mountain pond surrounded by blue and purple Neelakurinji flowers under a twilight sky, jackfruit tree nearby. Komban the young elephant with TWO tusks, KANNUKUTTI the bipedal yellow calf on two...
I controlli vengono generati dallo schema del modello. Il codice e il prezzo si aggiornano mentre li modifichi.
/run/minimax/h3/ref2va/trainer?wait=20
preventivo → 30,00 $
# Run the model; wait up to 20 s for the finished result in the same call
curl -X POST "https://api.doitong.ru/v1/run/minimax/h3/ref2va/trainer?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "training_data_url": "https://example.com/your-file.zip"
  }'

# Still "queued" or "running"? Poll with the id from the response:
curl "https://api.doitong.ru/v1/requests/REQUEST_ID?wait=20" \
  -H "Authorization: Bearer $DOITONG_API_KEY"
const API = "https://api.doitong.ru/v1";
const headers = {
"Authorization": "Bearer " + process.env.DOITONG_API_KEY,
"Content-Type": "application/json",
};
// Run the model; wait up to 20 s for the finished result in the same call
let res = await fetch(API + "/run/minimax/h3/ref2va/trainer?wait=20", {
method: "POST",
headers,
body: JSON.stringify({
"training_data_url": "https://example.com/your-file.zip"
}),
});
let request = await res.json();
if (!res.ok) throw new Error(request.error.code + ": " + request.error.message);
// Not finished yet: long-poll until it is
while (request.status === "queued" || request.status === "running") {
res = await fetch(API + "/requests/" + request.id + "?wait=20", { headers });
request = await res.json();
}
if (request.status !== "succeeded") throw new Error(JSON.stringify(request.error));
console.log(request.outputs.map((o) => o.url), request.cost.credits + " API credits ($" + request.cost.usd + ")");import os
import requests
API = "https://api.doitong.ru/v1"
headers = {"Authorization": "Bearer " + os.environ["DOITONG_API_KEY"]}
payload = {
"training_data_url": "https://example.com/your-file.zip",
}
# Run the model; wait up to 20 s for the finished result in the same call
r = requests.post(API + "/run/minimax/h3/ref2va/trainer", params={"wait": 20}, json=payload, headers=headers)
request = r.json()
if not r.ok:
raise RuntimeError(request["error"]["code"] + ": " + request["error"]["message"])
# Not finished yet: long-poll until it is
while request["status"] in ("queued", "running"):
request = requests.get(API + "/requests/" + request["id"], params={"wait": 20}, headers=headers).json()
if request["status"] != "succeeded":
raise RuntimeError(request["error"])
print([o["url"] for o in request["outputs"]], request["cost"]["credits"], "API credits", "$" + request["cost"]["usd"]){
"jsonrpc": "2.0",
"id": 1,
"method": "tools/call",
"params": {
"name": "run",
"arguments": {
"model_id": "minimax/h3/ref2va/trainer",
"input": {
"training_data_url": "https://example.com/your-file.zip"
},
"wait_seconds": 20
}
}
}La tua chiave rimane in questo browser: viene inviata solo al Doitong API e salvata in localStorage solo se selezioni Ricorda. Ottieni una chiave API
Addestra una LoRA su un archivio zip di clip video del soggetto, così gli input di riferimento possono guidare la generazione video. `reference_conditioning_p` imposta la frequenza d'uso dei riferimenti durante l'addestramento e `resume_from_lora_url` riprende da una LoRA addestrata in precedenza. Sono configurabili anche `rank`, `number_of_steps`, `number_of_frames`, `frame_rate` e `aspect_ratio`. Restituisce i pesi e un file di configurazione.
training_data_urlobbligatorio
rankfacoltativo
number_of_stepsfacoltativo
learning_ratefacoltativo
number_of_framesfacoltativo
frame_ratefacoltativo
resolutionfacoltativo
aspect_ratiofacoltativo
trigger_phrasefacoltativo
reference_conditioning_pfacoltativo
resume_from_lora_urlfacoltativo
auto_scale_inputfacoltativo
split_input_into_scenesfacoltativo
split_input_duration_thresholdfacoltativo
debug_datasetfacoltativo
strict_datasetfacoltativo
{
  "id": "req_8k2m4q7x1z9c3v5b6n0p2r4t",
  "object": "request",
  "model": "minimax/h3/ref2va/trainer",
  "status": "succeeded",
  "created_at": "2026-10-20T12:00:00Z",
  "started_at": "2026-10-20T12:00:02Z",
  "completed_at": "2026-10-20T12:00:09Z",
  "queue_position": null,
  "cost": {
    "credits": 30000,
    "usd": "30.00",
    "charged": 30000,
    "refunded": 0
  },
  "input": {
    "training_data_url": "https://example.com/your-file.zip"
  },
  "output": {
    "lora_file": {
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_name": "0-output.jpeg",
      "file_size": 1843200
    },
    "config_file": {
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_name": "0-output.jpeg",
      "file_size": 1843200
    },
    "debug_dataset": {
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_name": "0-output.jpeg",
      "file_size": 1843200
    }
  },
  "outputs": [
    {
      "type": "file",
      "url": "https://content.doitong.com/dev-api/2026/10/20/req_8k2m4q7x1z9c3v5b6n0p2r4t/0-output.jpeg",
      "content_type": "image/jpeg",
      "file_size": 1843200,
      "stored": true
    }
  ],
  "error": null,
  "metrics": {
    "inference_seconds": 6.8
  },
  "urls": {
    "self": "https://api.doitong.ru/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t",
    "cancel": "https://api.doitong.ru/v1/requests/req_8k2m4q7x1z9c3v5b6n0p2r4t/cancel"
  }
}Per gli agenti AI: questa pagina in Markdown è disponibile all'indirizzo https://doitong.com/it/developers/models/minimax/h3/ref2va/trainer.md. Tutti i modelli e le guide: https://doitong.com/developers/llms.txt