Obraz
FLUX.1 [dev] Warianty: 5
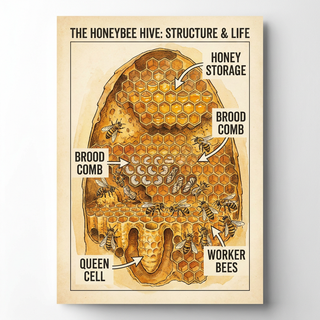
Uniwersalny model FLUX z otwartymi wagami, ostrzejszy i wierniej realizujący długie prompty niż schnell.
0,025 $ / megapiksel
25 kredytów API / megapiksel · ≈ 2,62 ₽
Brak wyników. Spróbuj „video”, „FLUX” lub „webhooks”.
Ładowanie modeli…
Uniwersalny model FLUX z otwartymi wagami, ostrzejszy i wierniej realizujący długie prompty niż schnell.
Precyzyjna lokalna edycja z jednego obrazu referencyjnego, na przykład zmiana kolorów, dodawanie obiektów lub przepisywanie tekstu.
Model wideo Black Forest Labs, klipy od 5 do 20 sekund z dźwiękiem w rozdzielczości 720p lub 1080p.
Tworzy z jednego portretu i ścieżki głosowej film z mówiącym, gestykulującym awatarem.
Skalowanie obrazu w górę przez Topaz Labs z odzyskiwaniem twarzy, redukcją szumu i wyostrzaniem do 4x.
Dokładne, bezpieczne komercyjnie usuwanie tła z produktów i osób.
Żaden model nie pasuje do tych filtrów
Wyczyść filtryOdczytuje tekst z obrazu i zwraca go jako zwykły tekst
florence-2-large/caption-to-phrase-groundingEdycja obrazów
≈ 0,003 $
Integracja
florence-2-large/dense-region-captionEdycja obrazów
≈ 0,004 $
Integracja
florence-2-large/object-detectionEdycja obrazów
≈ 0,003 $
Integracja
florence-2-large/ocr-with-regionEdycja obrazów
≈ 0,004 $
Integracja
florence-2-large/open-vocabulary-detectionEdycja obrazów
≈ 0,003 $
Integracja
florence-2-large/referring-expression-segmentationEdycja obrazów
≈ 0,005 $
Integracja
florence-2-large/region-proposalEdycja obrazów
≈ 0,003 $
Integracja
florence-2-large/region-to-segmentationEdycja obrazów
≈ 0,009 $
Integracja
florence-2-large/captionWizja
≈ 0,003 $
Integracja
florence-2-large/detailed-captionWizja
≈ 0,004 $
Integracja
florence-2-large/ocrWizja
≈ 0,003 $
Integracja
florence-2-large/region-to-categoryWizja
≈ 0,003 $
Integracja
florence-2-large/more-detailed-captionWizja
≈ 0,004 $
Integracja
florence-2-large/region-to-descriptionWizja
≈ 0,003 $
Integracja